Construyendo este blog con Astro: Lecciones y caídas desde las trincheras
- 1. ¿Por qué Astro?
- 2. No todo es color de rosa
- 3. Cosas divertidas
- 4. Conclusiones
- 5. Lo que está por venir
Este es el primer artículo del blog, y he querido aprovecharlo para documentar cómo está construido, las decisiones técnicas que tomé y algunos de los problemas que me encontré por el camino.
1. ¿Por qué Astro?
Siempre había escuchado que Astro era rápido, con un rendimiento increíble y tan sencillo de usar que en una tarde ya podías estar construyendo algo. Y razón no les faltaba.
Una creencia bastante popular suele ser que la gran mayoría de los sitios web de hoy en día son solo texto, imágenes y un par de componentes interactivos. Por lo tanto, usar la gran mayoría de frameworks actuales suele traducirse en enviar JavaScript innecesario al cliente en la primera carga del sitio web. Por eso mismo Astro encaja tan bien con la filosofía de “Construir sitios web más rápidos enviando menos JavaScript al navegador”. Y con esto no quiero dar a entender que usar cualquier otra tecnología esté mal, pero para este caso en concreto creo que es la mejor decisión.
Además, Astro aplica una arquitectura de islas: entrega HTML estático por defecto y solo carga e hidrata los componentes interactivos que lo necesitan. Es una diferencia importante frente a una página estática sin más, porque permite añadir interactividad sin convertir toda la vista en una aplicación cliente.
Si bien es cierto que Astro no envía ningún JavaScript por defecto al cliente, en este proyecto sí uso algunas soluciones que necesitan ejecutar código en la primera carga, como Sentry para el reporte de excepciones y la monitorización del rendimiento (APM). Aun así, al no arrastrar un runtime pesado, en la ejecución que muestro la carga inicial consigue un FCP de 0,3 segundos y un LCP de 0,3 segundos.
A continuación te comparto las métricas de Lighthouse de mi sitio web:
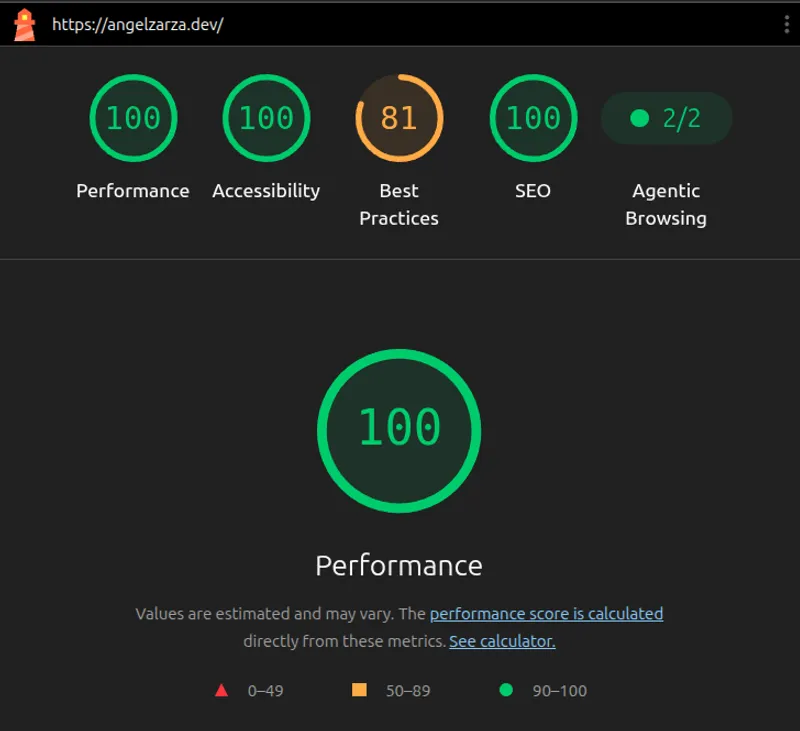
Por lo general, el rendimiento es excelente: 100 en Performance,
Accessibility y SEO. La métrica de Mejores Prácticas se queda en
81 debido a un script de terceros inyectado por Cloudflare
JavaScript Detections, concretamente
cdn-cgi/challenge-platform/scripts/jsd/main.js. En esta ejecución,
Lighthouse detecta que ese script utiliza APIs del navegador que
aparecen marcadas como obsoletas o en proceso de deprecación. Es un
comportamiento generado por la capa de Cloudflare y que no controlo
directamente desde el código del blog.
También adjunto las métricas de Core Web Vitals y tiempos de renderizado de esta prueba de laboratorio:
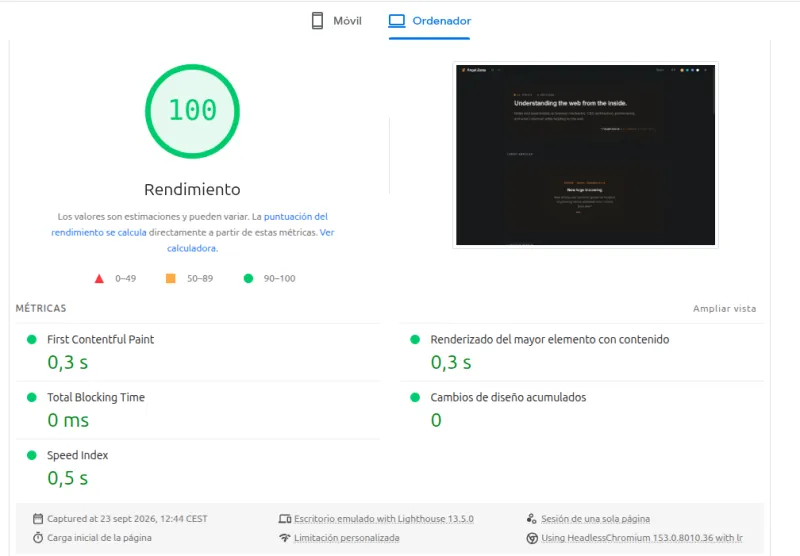
Como se puede ver en el reporte, el Total Blocking Time (TBT) es de 0 ms, el Speed Index es de 0,5 s, el LCP se mantiene en 0,3 s y el Cumulative Layout Shift (CLS) es de 0.
No incluyo un valor de INP porque esta medición de Lighthouse es una prueba de laboratorio y no una métrica de interacción real recogida de usuarios. Para analizar INP de forma representativa habría que recurrir a datos de campo.
2. No todo es color de rosa
Para este proyecto decidí usar una arquitectura híbrida, con las páginas que pueden prerenderizarse generadas de forma estática y las partes dinámicas ejecutándose bajo demanda en el Edge de Cloudflare. Esto me permite mantener el contenido del blog estático cuando no necesita procesamiento en tiempo de ejecución, pero seguir teniendo un backend cuando una funcionalidad lo requiere.
Estos son algunos de los paquetes clave del package.json:
{
  "dependencies": {
    "@astrojs/cloudflare": "14.3.2",
    "@libsql/client": "0.18.0",
    "@sentry/astro": "10.75.0",
    "astro": "7.3.3",
    "drizzle-orm": "0.45.2"
  }
}
Versiones actuales al momento de escribir este artículo, es probable que la información varíe en futuras entregas.
Sobre Sentry, lo utilizo exclusivamente para capturar excepciones no controladas y monitorizar el rendimiento del sitio, respetando la privacidad del usuario (puedes consultar la política de privacidad para más detalles).
En cuanto a la base de datos (Turso/LibSQL) y el ORM (Drizzle), se usan
para llevar el conteo de likes de cada artículo. Todo este flujo se
gestiona mediante una Astro Action (actions.likes.toggle) que se
ejecuta en el runtime de Cloudflare, por lo que la comunicación con la
base de datos ocurre en el servidor y no se envía código de Drizzle ni
del cliente de LibSQL al navegador. En concreto, importo createClient
desde @libsql/client/web, la entrada del paquete adecuada para el
runtime web de Cloudflare Workers.
Los problemas principales que me encontré durante el desarrollo estuvieron en dos frentes: Biome y Cloudflare/Vite.
Para quien no lo conozca, Biome es un linter y
formateador ultra rápido escrito en Rust. En la versión 2.5 que utilizo,
el soporte para archivos .astro depende de
experimentalFullSupportEnabled y había mejorado bastante, pero en mi
proyecto seguía encontrándome algunos falsos positivos relacionados con
el código del frontmatter.
Para no luchar constantemente contra el linter, apliqué un ajuste
temporal de configuración en biome.json deshabilitando
noUnusedImports y noUnusedVariables únicamente en componentes
.astro:
{
  "html": {
    "experimentalFullSupportEnabled": true
  },
  "overrides": [
    {
      "includes": ["**/*.astro"],
      "linter": {
        "rules": {
          "correctness": {
            "noUnusedImports": "off",
            "noUnusedVariables": "off"
          }
        }
      }
    }
  ]
}
Este ajuste tiene un trade-off bastante claro: Biome deja de detectar
imports y variables sin utilizar dentro de los archivos .astro. Por
ahora prefiero asumir esa limitación antes que tener falsos positivos
constantemente, pero es algo que tendré que revisar a medida que mejore
el soporte de Astro en Biome.
Mantengo Prettier como formateador secundario para el contenido Markdown, MDX y YAML; el hook de precommit lo aplica a esos formatos y Biome se encarga del código del proyecto.
Por último, surgió un problema con la integración entre Astro, Vite y el adaptador de Cloudflare. En modo desarrollo, Vite puede descubrir nuevas dependencias durante la ejecución y volver a optimizarlas. En mi caso, esta combinación provocaba problemas con el HMR al trabajar con algunas dependencias con interoperabilidad entre CJS y ESM.
Para evitar que Vite descubra y vuelva a optimizar dependencias
dinámicamente, añadí noDiscovery: true y declaré explícitamente las
dependencias que quiero preempaquetar:
vite: {
  optimizeDeps: {
    noDiscovery: true,
    include: [
      "@libsql/client/web",
      "drizzle-orm",
      "drizzle-orm/libsql",
      "drizzle-orm/sqlite-core",
      "@sentry/astro",
      "baseline-status",
    ],
  },
  ssr: {
    optimizeDeps: {
      noDiscovery: true,
    },
  },
},
De esta forma, Vite deja de intentar descubrir dependencias nuevas
durante el desarrollo y se limita a optimizar las que he indicado
explícitamente. En mi caso, esto solucionó el problema de HMR que estaba
teniendo al trabajar en local. La contrapartida es que, si añado una
dependencia que necesite preempaquetarse, debo incorporarla al array
include.
3. Cosas divertidas
Me gustaría tratar más temas de Astro en el futuro, pero de momento comentaré dos características de optimización web que me parecen interesantes: Speculation Rules y Prefetch, que cuentan cada vez con mejor soporte en navegadores.
<link rel="prefetch"> adelanta la descarga de un recurso para tenerlo
en caché, mientras que las reglas de especulación también pueden llegar
a prerenderizar una página. Por eso las segundas pueden ahorrar más
trabajo en una futura navegación, pero también consumen más recursos.
Te dejo también un pequeño CodePen que he creado por si te interesa conocer mejor la diferencia entre ambas tecnologías:
💡 Sobre la demo: este ejemplo muestra la idea detrás de
<link rel="prefetch">y de la Speculation Rules API. El entorno embebido de CodePen no permite ejecutar estas funcionalidades como página principal, pero puedes abrir el Pen para consultar y experimentar con el código en tu entorno local.
4. Conclusiones
Al final del día siento que este stack es una combinación muy potente: integración sencilla, costes de infraestructura muy bajos y un rendimiento envidiable. Si tuviera que comenzar un proyecto personal nuevo desde cero, volvería a elegir este ecosistema sin dudarlo.
5. Lo que está por venir
Gracias por haber llegado hasta aquí, espero que te haya resultado interesante como primera toma de contacto con el blog. Mi intención es seguir escribiendo con frecuencia y compartir contenido sobre desarrollo web e ingeniería.
Te invito a pasarte por mi perfil de GitHub y mi LinkedIn para estar al tanto de los próximos artículos o proyectos. También puedes suscribirte a la newsletter al final de la página para no perderte ninguna novedad.
¡Muchas gracias y hasta pronto!